Calidad nivel Saiyan: automatizando los test de calidad y gobernanza de Microsoft Fabric
Cómo implementar validaciones automáticas para que tus modelos de datos alcancen el siguiente nivel
En el vertiginoso universo del análisis de datos, donde la velocidad es clave pero la calidad es reina 👑, mantener el equilibrio puede ser más complicado que encontrar las siete Bolas de Dragón. Este proyecto es tu radar particular: una solución de CI/CD para Microsoft Fabric diseñada para que tus entregas sean rápidas y tu código, impecable. ¡Porque admitámoslo, a nadie le gusta heredar un modelo de datos que parece un plato de espaguetis🍝!
Esta serie de artículos te guiarán por el camino de la automatización de validaciones, análisis de calidad y gobernanza en tus desarrollos de Fabric. Su objetivo es garantizar:
✅ Calidad de datos consistente: Mediante validación automática de modelos y reportes
🏛️ Gobernanza de datos: Con implementación rigurosa de estándares de nomenclatura
🏃♂️ Desarrollo ágil: Integración continua que permite detección temprana de problemas
📈 Escalabilidad: Arquitectura preparada para adaptarse a necesidades crecientes
La solución se basa en una arquitectura con distintas capas para ingesta, modelado y visualización de datos. Hoy veremos el repositorio del proyecto y nos centraremos en dos puntos clave: la estandarización de nombres (¡adiós, caos!👋) y la caza de elementos no utilizados (¡hola, optimización!✨).
🏗️Estructura del repositorio
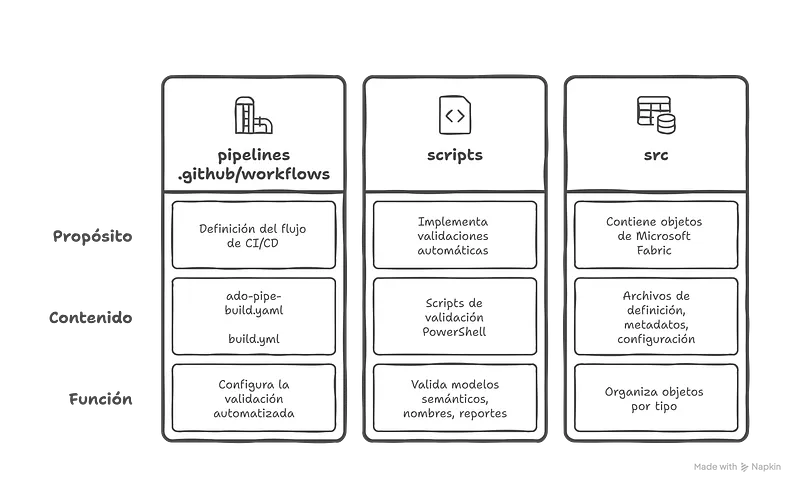
El proyecto está organizado de manera modular para facilitar la automatización y el mantenimiento:
- 📁 pipelines y 📁.github/workflows: Estos directorios contienen las configuraciones para la automatización.
- En 📁 pipelines, se encuentra 📄ado-pipe-build.yaml. Este archivo define el flujo de trabajo para las validaciones automáticas cuando se utiliza Azure DevOps como plataforma de CI/CD.
- Paralelamente, en 📁.github/workflows, 📄build.yml, se define la configuración para GitHub Actions.
La existencia de ambos archivos te da la libertad de elegir tu plataforma favorita. ¿Eres más de Azure DevOps 🔷 o prefieres GitHub 🐙? Como diría Goku: “¡La técnica correcta es la que funciona para ti!”. Cada plataforma tiene su propia manera de definir estos flujos de trabajo, pero al final ambas te llevan al mismo destino: calidad automatizada.
📁 scripts: El arsenal de scripts PowerShell. Cada uno es un especialista: modelos semánticos, reportes, convenciones de nombres y limpieza de elementos huérfanos.
📁 src: El corazón de tus creaciones en Fabric❤️ : .Report, .SemanticModel, .Lakehouse, etc. Todo bien organizado, como debe ser.
Tanto la pipeline de Azure DevOps como la GitHub Action se encargan de poner en marcha estos scripts PowerShell:
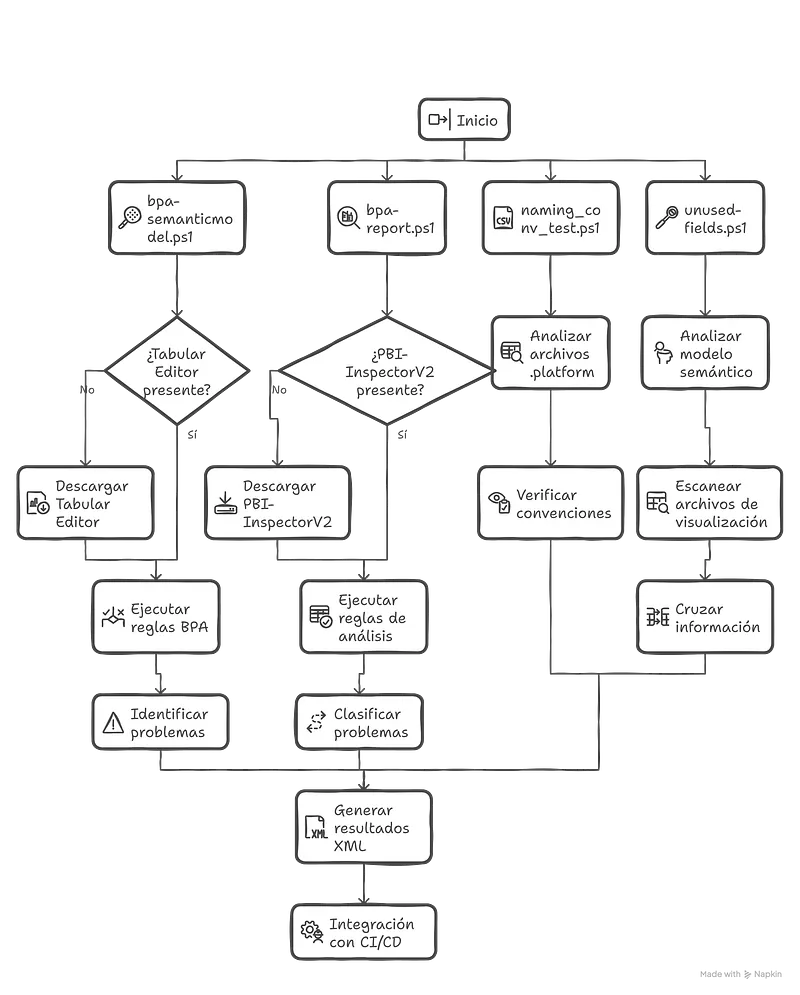
1. Best Practice Analyzer para modelos semánticos (**bpa-semanticmodel.ps1**) 📦
Este script, basado en el trabajo de Rui Romano, analiza modelos semánticos de Power BI para verificar el cumplimiento de buenas prácticas:
- Invoca a Tabular Editor (lo descarga si es necesario).
- Ejecuta reglas predefinidas (desde bpa-semanticmodel-rules.json) para detectar si te has olvidado de la tabla de fechas 📅, si hay relaciones perdidas en el limbo 🔗, o si tus medidas necesitan un buen formateo 📏.
- Genera resultados en formato XML compatible con NUnit
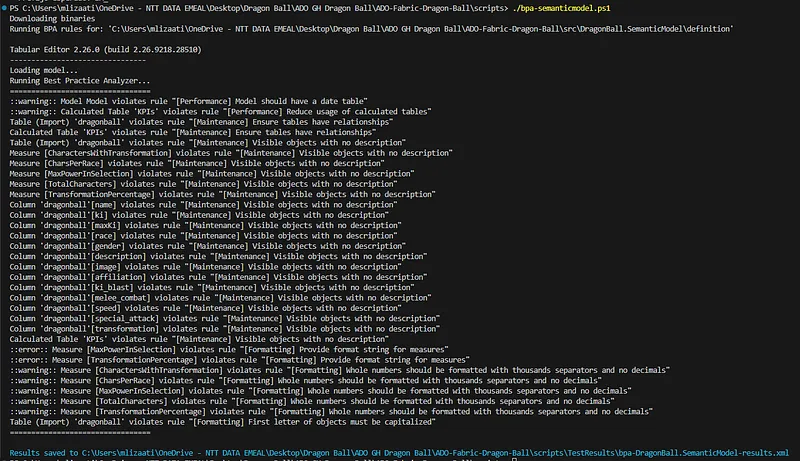 Este es el resultado si ejecutas desde Terminal el script
2. Best Practice Analyzer para reportes (bpa-report.ps1) 📊
También con la esencia de Rui Romano, este script le da un repaso a tus reportes de Power BI:
- Llama a PBI-InspectorV2 (sí, también lo descarga si hace falta).
- Busca problemas de rendimiento (¿demasiados visuales por página, quizás?🐢), visualizaciones que podrían ser más eficientes, y detalles de accesibilidad ♿ o formato.
- Clasifica problemas por severidad (errores ❌, advertencias ⚠️, información ℹ️)
- Y sí, también genera un informe XML 📝.
 Este es el resultado si ejecutas desde Terminal el script
3. Convenciones de nomenclatura (naming_conv_test.ps1) 🏷️
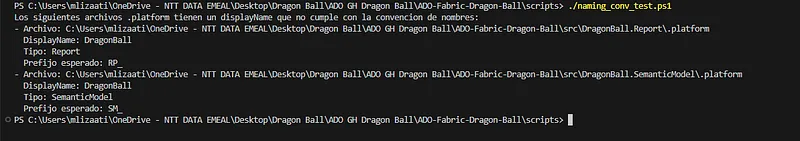 Este es el resultado si ejecutas desde Terminal el script
Con la inspiración del Data-Marc Blog, este script juega un papel crucial en la gobernanza de datos al garantizar que todos los componentes sigan una convención de nombres estandarizada.
¿Su misión? Asegurar que los displayName en los archivos .platform sigan el patrón establecido. Por ejemplo, un modelo semántico debería empezar con SM_ (y no con “EsteModeloEsMio_” o cosas por el estilo que hemos visto por ahí…😉).
¿Cómo lo hace?
- 🔎 Localiza todos los archivos .platform.
- Extrae el displayName y el type.
- ⚔️ Compara con la convención. ¡Sin piedad!
- 📄 Genera un informe XML para que puedas presumir (o corregir) los nombres de tus objetos de Microsoft Fabric.
Beneficios: Organización, claridad, consistencia y mejor trazabilidad. ¡Todo son ventajas!
4. Detección de campos no utilizados (unused-fields.ps1) 🧹
Inspirado en la filosofía de Measure Killer, (y un poco en Marie Kondo, si nos apuras✨), este script te ayuda a deshacerte de lo que no necesitas. “Si ese campo no te genera alegría en tus dashboards, ¡agradécele su servicio y elimínalo!”🙏
¿Su objetivo? Identificar columnas y medidas que están definidas pero no se usan en ningún sitio.
Su método:
- 🗺️ Mapea las páginas de tus informes.
- 📦 Escanea los archivos TMDL para hacer un inventario de tu modelo.
- 👀 Revisa los
visual.jsonpara ver qué se usa de verdad. - 💨 Cruza los datos: ¡lo que está en el modelo pero no en los visuales, es candidato a desaparecer!
- 📑 Genera un informe XML detallado.
🕵️♀ ️Información que te da: Te chiva en qué páginas y visuales se usa cada campo. Ejemplo: COLUMNA: Fecha [Pagina: 'Resumen' - Visuales: table | Pagina: 'Detalle' - Visuales: slicer]
🧘Beneficios: Modelos más ligeros, mejor rendimiento, mantenimiento más sencillo y claridad para los desarrolladores. ¡Menos es más!
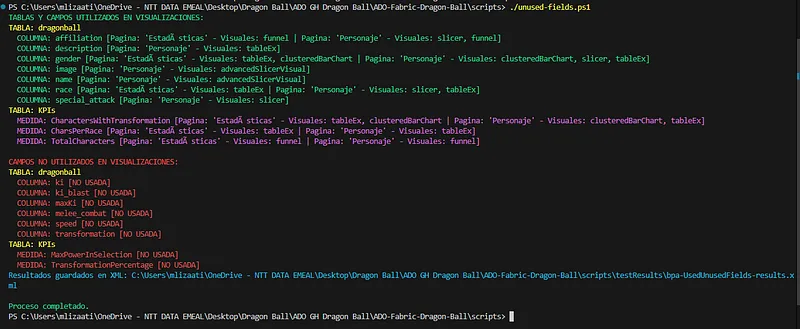 ./Este es el resultado si ejecutas desde local el script
💪 El Nivel Super Saiyan de tus datos está al alcance
¡Y ahí lo tienes! Con este arsenal de scripts PowerShell, tus proyectos de Microsoft Fabric alcanzarán un nivel de calidad digno de la sala del tiempo. Los scripts naming_conv_test.ps1 y unused-fields.ps1 se convertirán en tus aliados más fieles en la batalla contra el caos y la ineficiencia.
No solo mejorarás la calidad de tus modelos de datos, sino que establecerás una cultura donde la excelencia no es opcional — es el estado por defecto. Como diría Vegeta: “La mediocridad es para los débiles”. 😤
¿Listo para la acción? Puedes encontrar todos los scripts y la configuración base en GitHub. Dependiendo de tu plataforma de CI/CD preferida, tienes estas opciones:
🔷 Para Azure DevOps: marlizana/ADO-Fabric-Dragon-Ball
🐙 Para GitHub: marlizana/GH-Fabric-Dragon-Ball
Si has llegado hasta aquí no serás de los que les da pereza leer…pero por si acaso ¡Estás de suerte! Ahí va un video con el paso a paso, desde como clonarte el repo de GitHub a como ejecutar los scripts en tu local 😉
Y ahora que tienes acceso al código base, ¡es el momento de poner esos scripts en piloto automático🤖! Ya puedes consultar nuestras guías detalladas para configurar todo el proceso de validación en tu plataforma CI/CD:
🔷 Para Azure DevOps: Aprende a configurar tus Pipelines y políticas de rama para una calidad de acero aquí.
🐙 Para GitHub: Descubre cómo dominar GitHub Actions y las reglas de protección con precisión de samurái aquí.
¿Te ha servido? Aplaude, sin cuenta. Puedes hacerlo varias veces.
Comentarios