🧭 Guía para principiantes: Bursting, Smoothing y Throttling en Microsoft Fabric
(o cómo Fabric decide cuándo darte turbo, cuándo cobrarte la fiesta y cuándo decirte «relájate, criatura»)
(o cómo Fabric decide cuándo darte turbo, cuándo cobrarte la fiesta y cuándo decirte «relájate, criatura»)
TL;DR: Bursting = turbo, smoothing = deuda temporal, throttling = freno cuando te emocionas. Entender este trío es el ABC para optimizar costes, rendimiento y el consumo de CUs en Microsoft Fabric.
El sistema de capacity management de Microsoft Fabric puede parecer magia… o Hacienda. Bursting te da potencia extra cuando tus informes de Power BI, dataflows o notebooks van a tope; smoothing convierte ese empujón en un pago aplazado para que tu factura no llore; y throttling aparece cuando tu capacidad dice “hasta aquí hemos llegado”. Si sabes cómo bailan estos tres, puedes evitar sustos, ajustar workloads y mantener la capacidad bajo control sin sustos.
En esta guía te cuento deforma clara y práctica cómo funcionan los conceptos que hemos mencionado antes bursting, smoothing y throttling en Microsoft Fabric, cómo afecta cada uno al rendimiento y al coste, cómo medir tu consumo real de CUs, y qué herramientas oficiales puedes usar para monitorizar tus capacidades y tomar decisiones más eficientes.
Qué es un CU en Microsoft Fabric y por qué importa
En Fabric, el truco está en que el almacenamiento y el cómputo van por carreteras separadas: OneLake se paga por GB y el cómputo por CUs, que son la unidad real de potencia que Fabric consume y ajusta como si fuera un contador de ancho de banda hiperactivo.
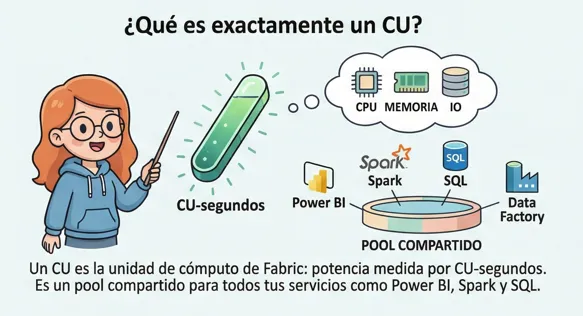 Qué es un CU en Microsoft Fabric. Imagen generada por IA
El viaje empieza con el concepto fundamental: el CU, es una unidad abstracta de cómputo que alquilas a Microsoft y que funciona como la moneda interna para ejecutar tus cargas, procesos,… que tengas dentro de Fabric.
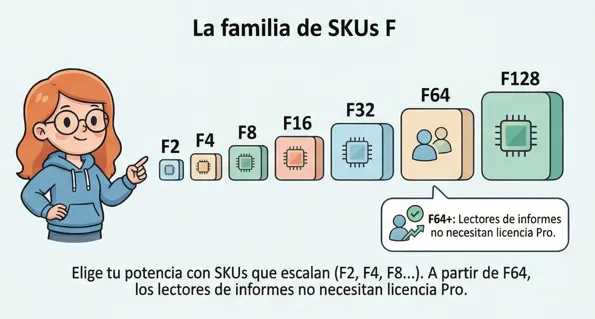 Capacidades de Microsoft Fabric. SKUs. Imagen generada por IA
Los tamaños de capacidad se comercializan en la familia F (F2, F4, F8, F16, etc.), y lo que realmente pagas no es la capacidad en sí, sino en forma de CU-segundos. Todos tus motores — Power BI, Spark, SQL, Data Factory — comparten la misma piscina de capacidad, lo que permite que unos liberen recursos mientras otros los consumen. Fabric decide internamente cómo repartirlo.
Pongamos un ejemplo, la capacidad F32 de Microsoft Fabric se define por tener 32 unidades de capacidad (CU).Para calcular la cantidad total de unidades de capacidad que tiene disponibles en una hora, se multiplica el número de CUs de la capacidad por la cantidad de segundos que hay en una hora (3.600 segundos). Por lo tanto, en una capacidad F34, dispondremos de un total de 115.200 CUs para consumir en una hora (32×3.600).
Además, la capacidad de Fabric se consume generalmente en intervalos de 30 segundos (llamados pit o point in time). En una F32, podrías utilizar 32×30=960 CUs en cada intervalo de 30 segundos.
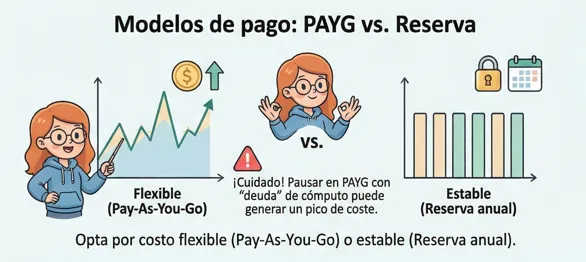 Modelos de pago en las capacidades de Fabric. Imagen generada por IA
A la hora de pagar, puedes optar por un modelo flexible Pay-As-You-Go, en el que solo pagas por lo que usas, o un modelo de reserva anual, más barato, pero menos flexible. Y sí, hay una joya escondida: a partir de F64, los usuarios que solo visualizan informes no necesitan licencia Pro. Encima, recuerda que el tamaño de la capacidad cubre solo el cómputo; el almacenamiento en OneLake se factura por separado. Y sí: incluso Copilot gasta CUs.
Fabric combina todo esto para decidir si puede darte turbo, si te lo cobra en diferido o si tiene que pararte los pies. Entender este baile entre PITs, tipos de carga y desacoplamiento de costes es lo que marca la diferencia entre una capacidad que fluye y una que te deja con cara de “¿quién se ha comido mis CUs?”
¿Y si necesito más de los 115.200 CUs hora de mi F32 para mis procesos?
Cómo funcionan las capacidades de Microsoft Fabric
Fabric no funciona como un servidor rígido de los de antes. En lugar de colapsar cuando te pasas de tu potencia contratada, responde de manera dinámica: te presta más cuando lo necesitas, lo equilibra cuando puede y te frena cuando te estás viniendo demasiado arriba. Esa lógica es la base de los tres mecanismos clave: bursting, smoothing y throttling.
Bursting en Microsoft Fabric: para qué sirve realmente
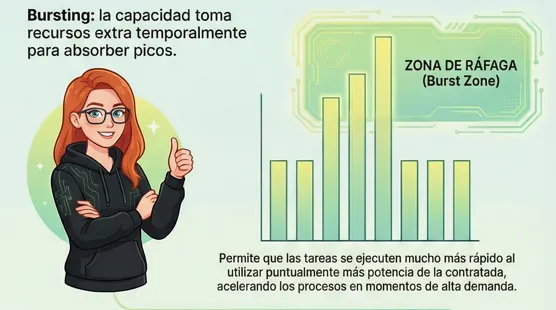 Bursting en Microsoft Fabric: para qué sirve realmente. Imagen generada por IA
Lo primero que hay que entender es que Fabric no te restringe a la potencia que has contratado. Si un motor necesita más CUs para ejecutar más rápido, Fabric te las presta durante unos segundos o minutos. Y sí, esto ocurre de verdad: si tienes una capacidad de 32 CUs y Spark decide que le hacen falta 96 CUs durante unos segundos para ir como un cohete, Fabric te las da sin pestañear. Tú no ves botones de “activar turbo”. Es automático.
El resultado práctico es simple: algo que debía tardar 40 segundos, tarda 10. Y tú tan feliz… hasta que toca mirar la letra pequeña.
Smoothing: cómo se compensa la deuda de CUs
¿Cuándo se aplica el smoothing?
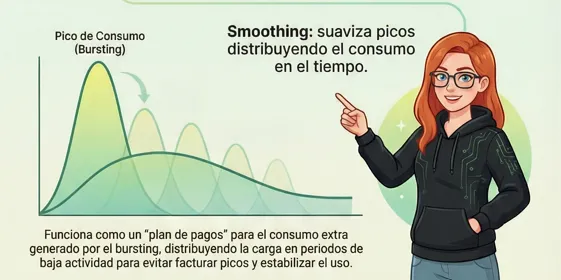 Smoothing: cómo se compensa la deuda de CUs. Imagen generada por IA
Cuando Fabric te da ese turbo, genera una deuda temporal. Es decir, si has usado 96 CUs cuando tenías 32, has consumido 64 CUs de más. Eso no se factura directamente, pero tampoco desaparece. Entra en juego el smoothing, un sistema que “reparte” esa deuda en el futuro mientras haya capacidad disponible.
Para workloads interactivos (Power BI, SQL, consultas rápidas) el smoothing se reparte en los siguientes cinco minutos. Para workloads en background, como notebooks Spark o pipelines, la deuda se reparte durante 24 horas. Ese tiempo sirve para que Fabric compense el exceso de potencia en momentos de poca carga.
Esto es clave: el smoothing se aplica siempre que hay bursting. No es negociable ni opcional. Tampoco es “malo”. Al contrario: evita que una carga puntual te obligue a contratar una capacidad más grande solo para sobrevivir a un pico concreto.
Throttling en Fabric: cuándo ocurre y cómo evitarlo
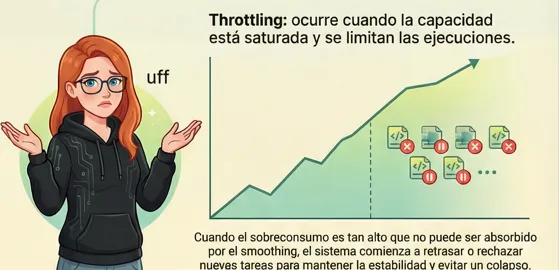 Throttling en Fabric: cuándo ocurre y cómo evitarlo. Imagen generada por IA
El problema aparece cuando la deuda de smoothing crece más rápido de lo que Fabric puede compensar. Si la capacidad futura no permite absorber el exceso, Fabric entra en modo autoprotección. Y ahí aparece el temido throttling, que no es un castigo, sino un mecanismo para evitar que la capacidad colapse.
El throttling no llega de golpe, sino por fases. Al principio solo notarás pequeños retrasos al ejecutar nuevas consultas interactivas. Si la deuda sigue subiendo, Fabric empieza a rechazar consultas interactivas, aunque todavía permite cargas en background. En la fase más alta, cuando la deuda es tan grande que necesitarías 24 horas de capacidad libre para pagarla, se rechazan todos los workloads nuevos, tanto interactivos como batch.
La trampa más cara: pausar la capacidad cuando tienes deuda
Aquí viene uno de los errores más comunes, y el más caro si estás en Pay-As-You-Go. Si justo después de un pico de bursting decides pausar la capacidad, el smoothing se detiene por completo. Y cuando se detiene, Fabric liquida toda la deuda inmediatamente, lo que genera un pico gigantesco de consumo en el mismo instante de la pausa.
En las SKUs F de reserva esto no se factura como coste adicional (solo queda feo en las métricas). Pero en capacidades de pago por uso, este pico se traduce directamente en euros. O en lágrimas, según el caso.
Y aquí es cuando empieza la ronda de preguntas existenciales que todos nos hacemos la primera vez…
¿Cómo sé si una capacidad está en throttling?
¿Cómo medir el consumo real de CUs?
Pues vamos al lio.
Cómo monitorizar capacidades en Microsoft Fabric
Fabric ofrece varios caminos: Capacity Metrics App, que es perfecta para entender lo que ha pasado en las últimas dos semanas, y el Fabric Toolbox, la verdadera navaja suiza del equipo CAT. Capacity Metrics te sirve para ver picos, smoothing, bursts y throttling de forma rápida, pero no te da contexto histórico ni desgloses avanzados. Con Fabric Toolbox, en cambio, podrás almacenar datos a largo plazo y analizarlos de verdad. FCA (Fabric Cost Analysis) te ayuda a entender el coste y consumo, FUAM (Fabric Unified Admin Monitoring) te aporta una visión completa como administradora, entre otras herramientas y aceleradores. Si vas a trabajar en serio con capacidades, el Toolbox no es opcional.
Cómo mantener tu capacidad de Microsoft Fabric a raya (sin perder CUs ni la paciencia)
1) Empieza por lo básico: planifica sin miedo
Antes de sacar la tarjeta, pásate por la calculadora de capacidades y hazte una idea de cuántas CUs vas a necesitar. Después, exprime la trial: viene con una F4 (y puedes subirla hasta F64), así que migra tu informe y tu modelo semántico más pesado y mira cómo respira.
Si tu carga va a toda máquina más del 60% del tiempo, la Reserva anual te ahorra un buen pellizco. Si no, Pay-as-you-go y pausar cuando toque.
2) Vigila la capacidad como si fuera tu gato cuando te vas unos días
Instala la Capacity Metrics App (solo admins), revisa el consumo de los últimos días y activa alertas en el portal para no enterarte tarde del desastre. Si necesitas histórico largo o chargeback, tira de FUAM.
3) Entiende de dónde vienen los sustos
Aquí está la madre del cordero y no me cansaré de repetir:
- Bursting: Fabric te da turbo cuando lo necesitas, pero te lo cobra luego en cómodos (o no tan cómodos) plazos vía smoothing.
- Interactivas: Usuarios abriendo informes con medidas DAX intensitas a la vez = picos rojos = dolor. Mira la Compute Page y Timepoint del Capacity Metrics para entender que está sucediendo.
- Background: Refreshes, notebooks, dataflows… consumen y Fabric lo reparte durante 24h. Usa la Timepoint para ver cuánta deuda llevas y quién te la ha generado.
4) Optimiza sin perder la chispa
- Si puedes elegir, pro-code > low-code en consumo: PySpark suele ganar a dataflows o pipelines.
- Implementa cargas incrementales, evita los full refresh innecesarios y optimiza tus informes (sobre todo medidas y cardinalidades).
- En Pay-as-you-go, puedes pausar, pero ojo: si tienes deuda acumulada, te la cobran entera al parar. Si solo tienes actividad floja, es mejor hacer scale down que pulsar el botón rojo.
5) Pon límites antes de que la cosa explote
El throttling es tu red de seguridad. Conoce las reglas del juego:
- 10 min de deuda: retrasos de 20 s para cargas interactivas.
- 60 min de deuda: las interactivas empiezan a rechazarse.
- 24h de deuda acumulada: aquí ya no entra nada ni interactivo ni en background hasta que se libere crédito.
Conclusión
Fabric no es caótico, es bastante predecible. Tiene sus reglas, sus ciclos y sus mecanismos de autoprotección. Si entiendes cómo te presta potencia, cómo te la cobra, y cómo te frena cuando te flipas, empiezas a usar la capacidad a tu favor en lugar de luchar contra ella.
Y todo esto, si lo monitorizas bien, te evita sustos.
Microsoft Fabric no quiere fastidiarte. Quiere que aprendas a conducirlo sin quemar el motor. Si lo dominas, la plataforma deja de ser un misterio y empieza a comportarse como lo que es: un sistema inteligente de potencia bajo demanda que tú puedes gobernar con sentido. Entenderlo no solo evita sustos: te convierte en esa persona del equipo que por fin sabe por qué Fabric se comporta como se comporta.
¿Quieres ver en más detalle como monitorizar tu capacidad? Déjame un comentario y preparo un artículo para Capacity Metrics, FUAM y FCA.
Enlaces de interés
Plan your capacity size - Microsoft Fabric
*Learn how to plan your Microsoft Fabric capacity size using the Microsoft Fabric capacity metrics app.*learn.microsoft.com
Bursting and Smoothing - Yin and Yang of the Fabric Capacity! - Data Mozart
*Learn about two key concepts that balance your Fabric capacity workload, and how to save the money along the way!*data-mozart.com
GitHub - microsoft/fabric-toolbox: Fabric toolbox is a repository of tools, accelerators, scripts…
*Fabric toolbox is a repository of tools, accelerators, scripts, and samples to accelerate your success with Microsoft…*github.com
¿Te ha servido? Aplaude, sin cuenta. Puedes hacerlo varias veces.
Comentarios