Liquid Clustering en Fabric, qué es, cómo configurarlo y cuándo usarlo
Zygmunt Bauman hablaba de una modernidad “líquida”, donde las cosas ya no están pensadas para quedarse exactamente como estaban. Y el…
Zygmunt Bauman hablaba de una modernidad “líquida”, donde las cosas ya no están pensadas para quedarse exactamente como estaban. Y el nombre de Liquid Clustering viene bastante bien para explicar lo que ocurre aquí: la organización de tus datos tampoco tiene por qué quedarse congelada.
¿Qué es Liquid Clustering en Microsoft Fabric?
Liquid Clustering es una estrategia de organización física para tablas Delta que permite declarar las columnas que deben utilizarse para organizar los datos.
A diferencia del particionado estilo Hive, no crea una estructura de carpetas por cada valor. Y, a diferencia de Z-Order, no tienes que volver a especificar las columnas cada vez que ejecutas OPTIMIZE.
La definición de clustering se almacena en los metadatos de la tabla y OPTIMIZE utiliza esa información para reorganizar los datos.
El objetivo es mejorar el file skipping: que, cuando una consulta filtre por una columna de clustering, Fabric pueda descartar más ficheros sin tener que leerlos.
Pero antes de llegar ahí, merece la pena entender qué estamos intentando organizar.
Si ya tienes algo de conocimiento esta sección te la puedes saltar. Si cuando se habla de particionado estilo Hive, clustering declarativo o layout físico te suena a chino, estos párrafos son para ti.
Qué es una tabla Delta por dentro
Si vienes de SQL Server, “tabla” suena a una cosa compacta que vive en un sitio. En un lakehouse no es así.
Una tabla Delta son muchos ficheros Parquet guardados en OneLake, más un registro (el delta log) que apunta qué ficheros forman la versión actual de la tabla. Cuando insertas datos, no se modifica nada existente, se escriben ficheros nuevos y el log anota que ahora también cuentan. Una tabla de un año con carga diaria puede tener un montón.
Cada fichero lleva una pequeña etiqueta que dice qué contiene, cuál es la fecha más antigua, cuál es la más reciente, etc.
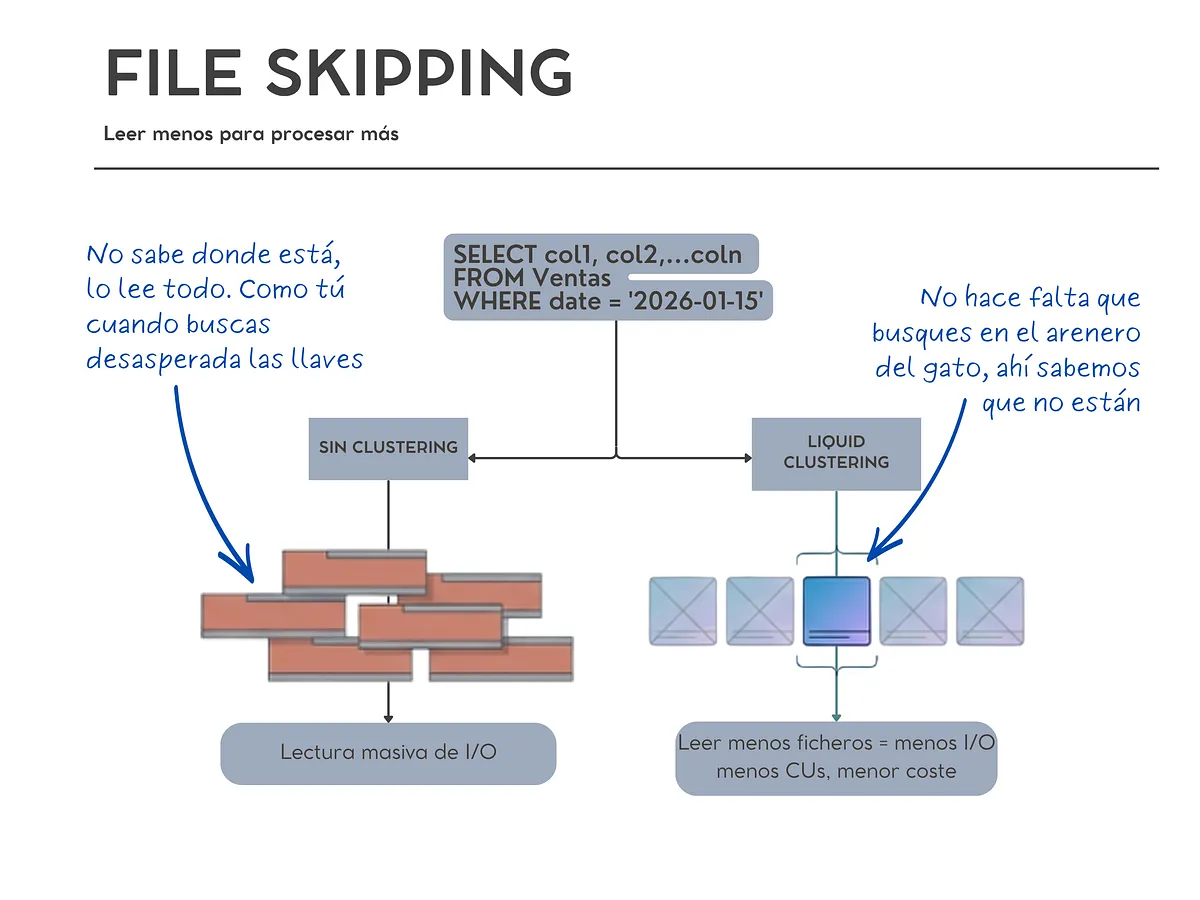 Cómo funciona el File Skipping
Cuando lanzas WHERE date = '2026-01-15', el motor no abre los mil ficheros. Mira primero esa etiqueta y descarta todos aquellos cuyo rango de fechas no incluye ese día, descartando así ficheros sin abrirlos. A esto se le llama file skipping.
Lo que determina cuántos se puede saltar es el layout físico, cómo están repartidas las filas entre ficheros. Si las ventas de enero están desperdigadas por los mil ficheros, todos los rangos incluyen enero y no se puede descartar ninguno. Si están concentradas en cinco, se lee cinco.
Y esa lectura es la que cuesta dinero. I/O (input/output) es, simplificando mucho, traer datos desde el almacenamiento para poder procesarlos. Y leer datos cuesta: menos ficheros leídos suele significar menos I/O, menos tiempo y menos CUs.
Organizar el layout físico es, básicamente, decidir qué filas acaban juntas en el mismo fichero. Hay varias formas de organizarlo. Vamos a ver las tres más importantes. Piensa en ellas como distintas maneras de ordenar una estantería de libros.
Particionado estático estilo Hive
Es lo clásico. Eliges una columna al crear la tabla y el sistema crea una carpeta física por cada valor distinto:
/ventas/region=norte/
/ventas/region=sur/
/ventas/region=este/
Filtras por región y el motor va directo a la carpeta. Rapidísimo… mientras filtres por región.
Se llama estático porque la decisión queda congelada en la estructura de directorios. Cambiar de columna de particionado significa reescribir la tabla entera, porque hay que mover todos los ficheros a carpetas nuevas.
Y tiene un problema conocido, si particionas por una columna con muchos valores distintos (fecha con hora, ID de cliente, código de producto), acabas con miles de carpetas con un fichero minúsculo dentro. Eso es el small file problem, y hace que las consultas vayan más lentas, no más rápidas, porque abrir mil ficheros de 2 MB cuesta mucho más que abrir diez de 200 MB.
Al número de valores distintos que tiene una columna se le llama cardinalidad y es lo mismo que en tu modelo semantico de Power BI. Imagina una tabla con 500 millones de ventas. Si particionas por pais y tienes 20 países, puedes acabar con unas pocas carpetas grandes. Si particionas por id_pedido, que puede tener cientos de millones de valores distintos, la cosa se pone bastante fea: demasiadas carpetas, demasiados ficheros pequeños.. Particionar por algo de alta cardinalidad…ves el posible desastre, ¿no?.
Z-Order
Aquí no se crean carpetas. Se reordenan las filas dentro de los ficheros para que las que tienen valores parecidos acaben juntas, y así los rangos min/max de cada fichero queden lo más estrechos posible.
Z-Order utiliza una curva de recorrido del espacio. El nombre parece bastante más complicado de lo que es. La idea es conseguir que los datos que están cerca en varias columnas terminen también cerca físicamente.
¿Para qué? Para que, cuando filtres por esas columnas, Fabric pueda descartar más ficheros.
El problema es que es mantenimiento manual. La instrucción es OPTIMIZE ventas ZORDER BY (order_date, region), y esa definición no se guarda en ningún sitio. Cada vez que lo lanzas tienes que volver a escribir las columnas. Si dentro de seis meses tu compañero lanza el OPTIMIZE con otras columnas, o sin ellas, el layout se deshace y nadie se entera. No hay una fuente de verdad sobre cómo debería estar organizada esa tabla. Solo lo que alguien escribió la última vez.
Qué es Liquid Clustering, la novedad en Fabric
Aquí está la diferencia importante. Liquid Clustering es declarativo, en lugar de dar la orden cada vez, declaras una vez cómo quieres que esté organizada la tabla y esa decisión queda guardada en los metadatos. A partir de ahí, OPTIMIZE ya sabe qué tiene que hacer.
Es la diferencia entre decirle a alguien cómo colocar cada cosa cada vez que entra, y dejar la norma escrita en la pared.
Sin carpetas físicas, con las columnas cambiables cuando quieras y sin reescribir la tabla para cambiarlas. Dejamos escrito cómo queremos organizarla y la casa sabe cómo mantener ese orden.
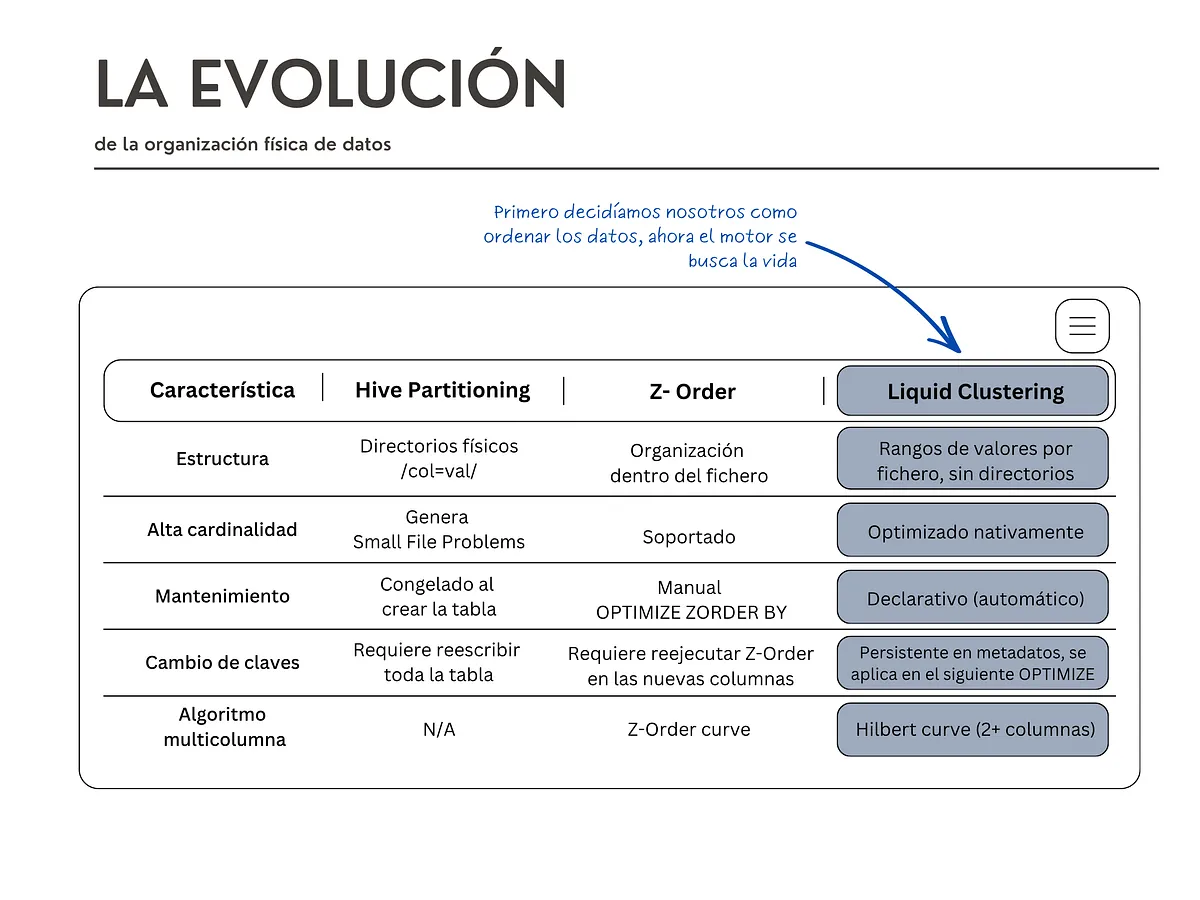 Tabla de características según la organización física de los datos
Una cosa importante: no puedes mezclarlo todo
Liquid Clustering y Hive Partitioning no son dos capas que puedas poner una encima de otra. En Fabric, tienes que elegir una estrategia para la tabla.La diferencia sencilla sería:
- Partitioning: divide físicamente los datos y puede venirte bien cuando necesitas aislar escrituras concurrentes.
- Liquid Clustering: organiza los datos pensando sobre todo en mejorar las lecturas y el file skipping.
Así que antes de pensar «¿cómo combino las dos?», la pregunta es más bien: ¿qué problema estoy intentando resolver?
Antes de empezar: ¿qué Runtime tienes?
Aquí hay una pequeña trampa: Liquid Clustering no se comporta exactamente igual en todos los Runtimes.
En Fabric:
- Runtime 1.3 → Delta Lake 3.2
- Runtime 2.0 → Delta Lake 4.2
En Runtime 2.0, el clustering incremental hace que OPTIMIZE pueda ir reorganizando los datos sin tener que rehacerlo todo cada vez.
En Runtime 1.3 también puedes trabajar con Liquid Clustering, pero tiene más limitaciones y el comportamiento de la optimización es diferente.
Así que, antes de copiar un ejemplo de Internet y pensar que Fabric se ha roto, mira primero qué Runtime estás usando.
Ahora sí, vamos a declarar el clustering
En una tabla nueva:
CREATE TABLE dbo.ventas (
    order_id BIGINT,
    order_date DATE,
    region STRING,
    amount DECIMAL(10,2)
) CLUSTER BY (order_date, region);
Desde una query:
CREATE TABLE dbo.ventas_clustered
CLUSTER BY (order_date, region)
AS SELECT * FROM raw_ventas;
O activarlo sobre una tabla que ya existe, sin reescribir nada:
ALTER TABLE dbo.ventas_txn CLUSTER BY (order_date, region);Para elegir las columnas:
- Entre 1 y 4, y las que salgan de verdad en tus
WHERE. No elijas las columnas que “parecen importantes” en el modelo. Elige las que realmente aparecen en los filtros de tus consultas. Más columnas no significa más optimización. Al contrario: cuanto más intentas optimizar a la vez, más difícil es conseguir que cada una quede bien organizada. - El orden da igual. El orden después de
CLUSTER BYno afecta al resultado. - Cuidado mezclando cardinalidades. Juntar una columna con tres valores distintos y otra con un millón aprovecha mal la de baja cardinalidad.
- Tipos NO válidos:
BooleanType,BinaryTypeyNullTypeno sirven como clave (un booleano solo tiene dos valores: no hay nada que ordenar). Numéricos, fechas, timestamps y strings sí. Los tipos complejos (Struct,Array,Map) solo desde Runtime 2.0 y activandospark.microsoft.delta.clusteredTable.complexTypes.enabled.
Vale, ¿y ahora quién mueve los ficheros?
Declarar las columnas no mueve ni un byte. Solo apunta la intención. Quien coloca los datos es OPTIMIZE:
OPTIMIZE ventas;Ya está. Sin ZORDER BY, sin acordarte de qué columnas pusiste la última vez, porque están en los metadatos.
En Runtime 2.0, además, el Native Execution Engine soporta OPTIMIZE sobre tablas clusterizadas y da entre un 30% y un 50% más de velocidad.
¿Y si mañana cambio de idea?
Que es todo el punto de esto:
-- Cambiar columnas
ALTER TABLE ventas CLUSTER BY (region, product_category);

-- Quitarlo
ALTER TABLE ventas CLUSTER BY NONE;
El layout nuevo se aplica en el siguiente OPTIMIZE. Los ficheros antiguos conservan su distribución previa hasta que les toca reorganizarse.
Cuando cambias de claves, lanza una vez:
OPTIMIZE ventas FULL;OPTIMIZE FULL fuerza la reorganización de los grupos que aún siguen el criterio antiguo. Es más caro, así que resérvalo para cuando cambies columnas o quieras un reset de calidad. No lo pongas en el pipeline diario.
¿Cómo sé si realmente ha mejorado?
No me fiaría solo de que OPTIMIZE haya terminado correctamente. Lo interesante es saber si realmente ha dejado el layout mejor. Desde Runtime 2.0 tienes un método para no ir a ciegas (solo Scala, de momento):
import io.delta.tables.DeltaTable

deltaTable = DeltaTable.forName(spark, "dbo.ventas")
display(deltaTable.clusteringQuality())
Devuelve una fila por columna de clustering. Las tres métricas que yo miraría:
avg_depth: te da una idea de cuántos ficheros tendría que tocar una consulta para encontrar un valor. Cuanto más cerca de 1, mejor.overlap_ratio: mide cuánto se pisan los rangos entre ficheros. Cuanto más bajo, mejor.skipping_effectiveness: indica cuánto puede descartar el motor gracias a las estadísticas de los ficheros. Cuanto más alto, mejor.
Lánzalo antes y después del OPTIMIZE y compara. Y ten presente que esto estima el potencial de file skipping a partir de las estadísticas de los ficheros: no mide el tiempo real de una query concreta.
Lo que conviene saber antes de meterlo en el pipeline
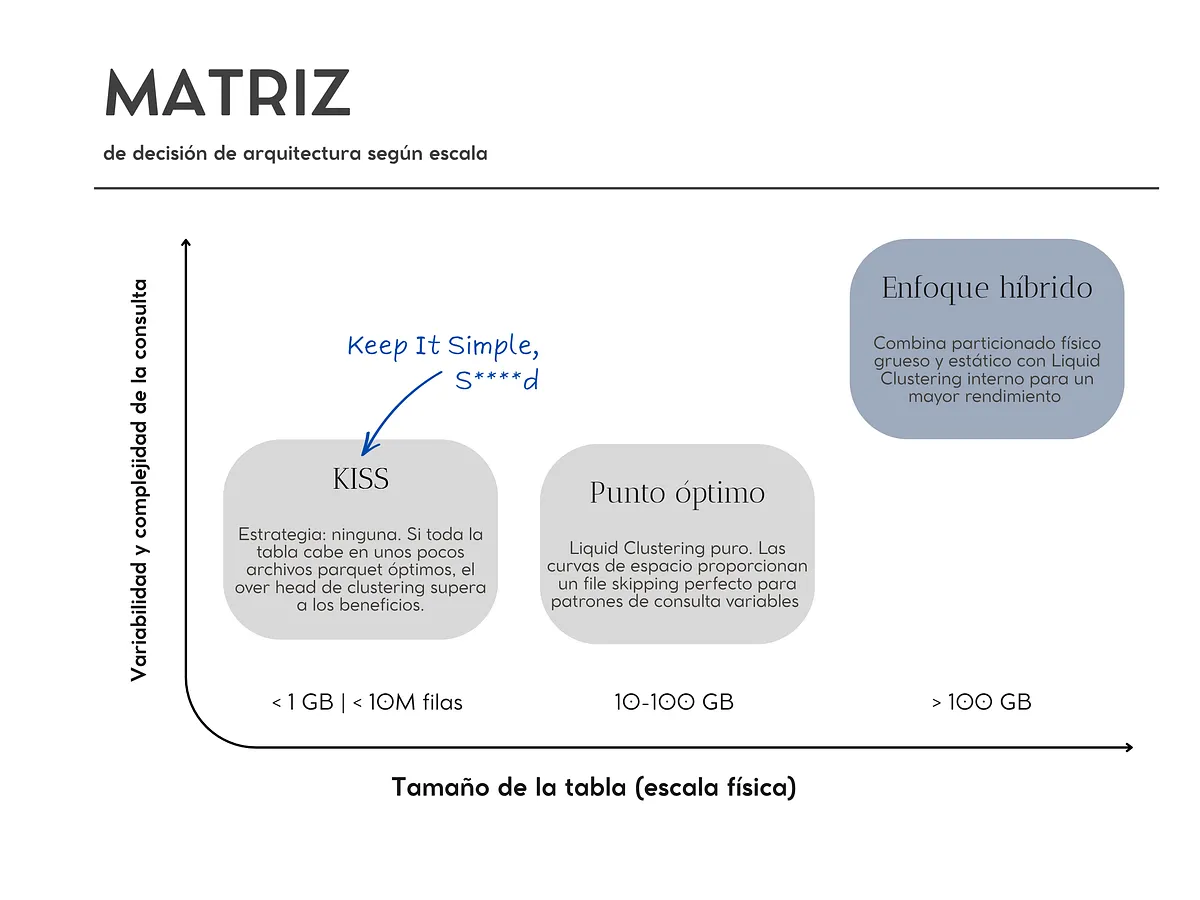 Matriz de decisión según el tamaño de la tabla
- Auto compaction: puede utilizarse para ayudar a mantener a raya el problema de los archivos pequeños.
- V-Order: compatible. Trabajan en ejes distintos. V-Order optimiza cómo está ordenado el contenido dentro de cada fichero; el clustering decide qué filas van a qué fichero.
- Optimize write: compatible, y recomendable en streaming para que cada tanda de datos no genere un enjambre de ficheros minúsculos.
- Notebooks Python: Aquí viene una de esas trampas que descubres cuando ya llevas media pipeline montada.No todos los motores que trabajan con Delta pueden escribir Liquid Clustering. En Fabric, la escritura de Liquid Clustering está soportada por Fabric Spark. Los notebooks Python no tienen ese soporte para escribir Liquid Clustering.No es que Python y Delta se lleven mal. Es simplemente que esta funcionalidad necesita Fabric Spark.De esas cosas que está bien saber antes y no cuando la pipeline ya está montada.
- Auto reclustering: en 2.0 va solo. Según llegan datos nuevos, los rangos de los ficheros se van solapando otra vez y el file skipping empeora. El motor lo detecta y reorganiza solo los ficheros afectados, dentro del
OPTIMIZEnormal. No hay que programar nada. - Deletion vectors: cuando borras filas, Delta no reescribe el fichero: apunta aparte qué filas hay que ignorar al leer. Los ficheros que acumulan demasiados borrados se seleccionan para reorganizarse aunque ya estuvieran bien clusterizados.
Si estás en Runtime 2.0, para mí Liquid Clustering debería estar bastante arriba en la lista de cosas que probar cuando una tabla empieza a tener problemas de layout. Te quitas de encima parte del mantenimiento manual de Z-Order y puedes cambiar las columnas de clustering sin rehacer la tabla.
Antes de lanzarte a cambiar el layout de una tabla, yo me haría cuatro preguntas:
- ¿Cómo se consulta esta tabla?
- ¿Tengo un problema de lectura o de escrituras concurrentes?
- ¿Qué Runtime y qué motor utiliza mi pipeline?
- ¿Realmente necesito cambiar cómo están organizados los datos?
Porque Liquid Clustering no es «la forma nueva de particionar».
Es otra forma de decirle a Fabric cómo quieres que organice tus datos para que encontrarlos sea más fácil.
Y ahora viene la parte que me interesa: ¿lo habéis probado ya? Sobre todo en tablas grandes, con muchos MERGE. Quiero saber qué avg_depth estáis viendo por ahí.
¿Te ha servido? Aplaude, sin cuenta. Puedes hacerlo varias veces.
Comentarios