Liquid Clustering a Fabric: què és, com configurar-lo i quan fer-lo servir
Com organitza Liquid Clustering les taules Delta a Microsoft Fabric, en què es diferencia del particionat i de Z-Order i quan fer-lo servir.
Zygmunt Bauman parlava d’una modernitat «líquida», on les coses ja no estan pensades per quedar-se exactament com estaven. I el nom de Liquid Clustering va força bé per explicar el que passa aquí: l’organització de les teves dades tampoc no s’ha de quedar congelada.
Què és Liquid Clustering a Microsoft Fabric?
Liquid Clustering és una estratègia d’organització física per a taules Delta que permet declarar les columnes que s’han de fer servir per organitzar les dades.
A diferència del particionat estil Hive, no crea una estructura de carpetes per cada valor. I, a diferència de Z-Order, no has de tornar a especificar les columnes cada vegada que executes OPTIMIZE.
La definició de clustering es desa a les metadades de la taula i OPTIMIZE fa servir aquesta informació per reorganitzar les dades.
L’objectiu és millorar el file skipping: que, quan una consulta filtri per una columna de clustering, Fabric pugui descartar més fitxers sense haver de llegir-los.
Però abans d’arribar-hi, val la pena entendre què intentem organitzar.
Si ja en tens una mica de coneixement, aquesta secció te la pots saltar. Si quan es parla de particionat estil Hive, clustering declaratiu o layout físic et sona a xinès, aquests paràgrafs són per a tu.
Què és una taula Delta per dins
Si véns de SQL Server, «taula» sona a una cosa compacta que viu en un lloc. En un lakehouse no és així.
Una taula Delta són molts fitxers Parquet desats a OneLake, més un registre (el delta log) que apunta quins fitxers formen la versió actual de la taula. Quan insereixes dades, no es modifica res del que ja hi ha: s’escriuen fitxers nous i el log anota que ara també compten. Una taula d’un any amb càrrega diària en pot tenir un munt.
Cada fitxer porta una petita etiqueta que diu què conté: quina és la data més antiga, quina és la més recent, etc.
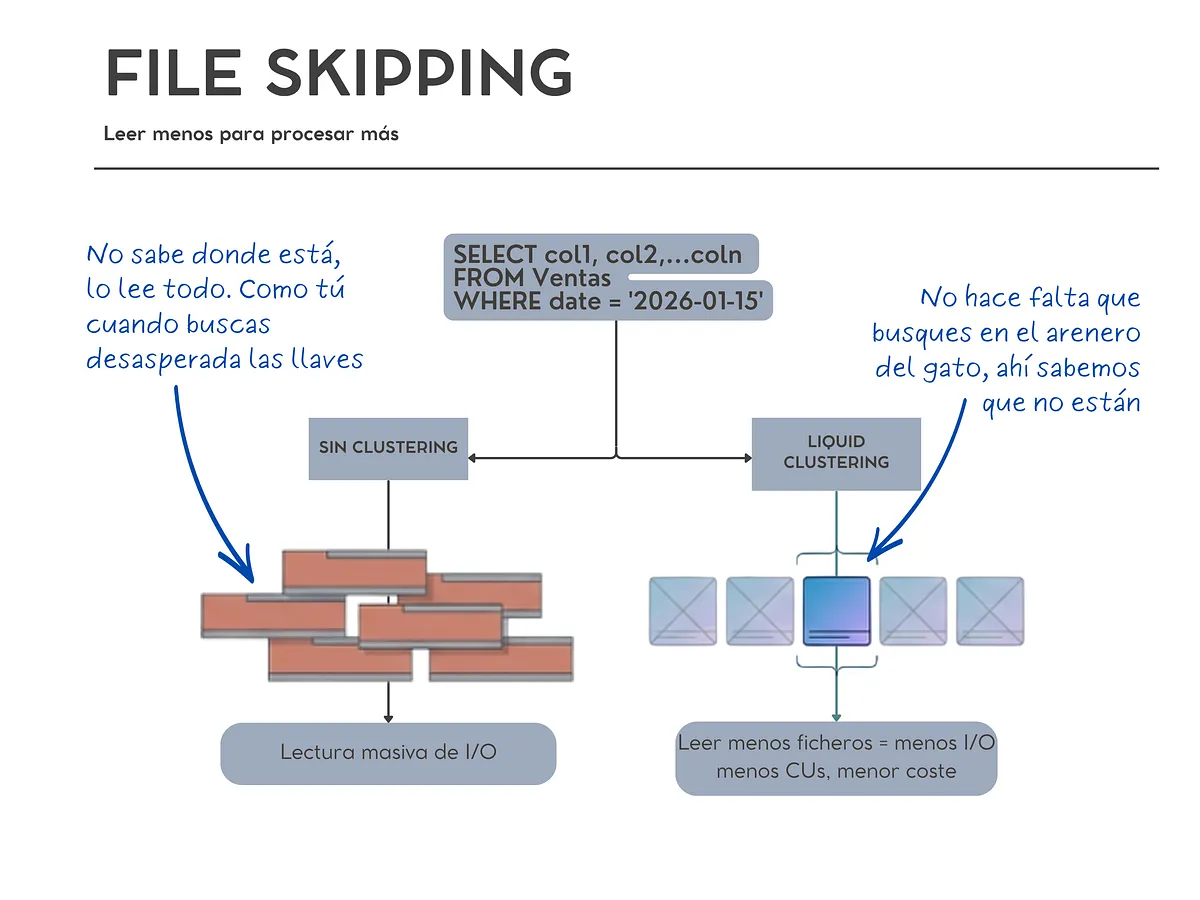 Com funciona el File Skipping
Quan llances WHERE date = '2026-01-15', el motor no obre els mil fitxers. Primer mira aquella etiqueta i descarta tots aquells el rang de dates dels quals no inclou aquell dia, de manera que descarta fitxers sense obrir-los. Això s’anomena file skipping.
El que determina quants se’n pot saltar és el layout físic: com estan repartides les files entre fitxers. Si les vendes de gener estan escampades pels mil fitxers, tots els rangs inclouen gener i no se’n pot descartar cap. Si estan concentrades en cinc, en llegeix cinc.
I aquesta lectura és la que costa diners. I/O (input/output) és, simplificant molt, portar dades des de l’emmagatzematge per poder processar-les. I llegir dades costa: menys fitxers llegits sol voler dir menys I/O, menys temps i menys CUs.
Organitzar el layout físic és, bàsicament, decidir quines files acaben juntes al mateix fitxer. Hi ha diverses maneres d’organitzar-lo. Vegem les tres més importants. Pensa-hi com en diferents maneres d’ordenar una prestatgeria de llibres.
Particionat estàtic estil Hive
És el clàssic. Tries una columna en crear la taula i el sistema crea una carpeta física per cada valor diferent:
/ventas/region=norte/
/ventas/region=sur/
/ventas/region=este/
Filtres per regió i el motor va directe a la carpeta. Rapidíssim… mentre filtris per regió.
S’anomena estàtic perquè la decisió queda congelada a l’estructura de directoris. Canviar de columna de particionat vol dir reescriure tota la taula, perquè cal moure tots els fitxers a carpetes noves.
I té un problema conegut: si particiones per una columna amb molts valors diferents (data amb hora, ID de client, codi de producte), acabes amb milers de carpetes amb un fitxer minúscul a dins. És el small file problem, i fa que les consultes vagin més lentes, no més ràpides, perquè obrir mil fitxers de 2 MB costa molt més que obrir-ne deu de 200 MB.
El nombre de valors diferents que té una columna s’anomena cardinalitat i és el mateix que al teu model semàntic de Power BI. Imagina una taula amb 500 milions de vendes. Si particiones per pais i tens 20 països, pots acabar amb unes poques carpetes grans. Si particiones per id_pedido, que pot tenir centenars de milions de valors diferents, la cosa es posa força lletja: massa carpetes, massa fitxers petits. Particionar per alguna cosa d’alta cardinalitat… veus el possible desastre, oi?
Z-Order
Aquí no es creen carpetes. Es reordenen les files dins dels fitxers perquè les que tenen valors semblants acabin juntes, i així els rangs min/max de cada fitxer quedin tan estrets com sigui possible.
Z-Order fa servir una corba de recorregut de l’espai. El nom sembla molt més complicat del que és. La idea és aconseguir que les dades que són a prop en diverses columnes acabin també a prop físicament.
Per a què? Perquè, quan filtris per aquestes columnes, Fabric pugui descartar més fitxers.
El problema és que és manteniment manual. La instrucció és OPTIMIZE ventas ZORDER BY (order_date, region), i aquesta definició no es desa enlloc. Cada vegada que la llances has de tornar a escriure les columnes. Si d’aquí a sis mesos el teu company llança l’OPTIMIZE amb altres columnes, o sense, el layout es desfà i ningú no se n’assabenta. No hi ha una font de veritat sobre com hauria d’estar organitzada aquella taula. Només el que algú va escriure l’última vegada.
Què és Liquid Clustering, la novetat a Fabric
Aquí hi ha la diferència important. Liquid Clustering és declaratiu: en lloc de donar l’ordre cada vegada, declares un cop com vols que estigui organitzada la taula i aquesta decisió queda desada a les metadades. A partir d’aquí, OPTIMIZE ja sap què ha de fer.
És la diferència entre dir-li a algú com ha de col·locar cada cosa cada vegada que entra, i deixar la norma escrita a la paret.
Sense carpetes físiques, amb les columnes canviables quan vulguis i sense reescriure la taula per canviar-les. Deixem escrit com la volem organitzar i la casa sap com mantenir aquest ordre.
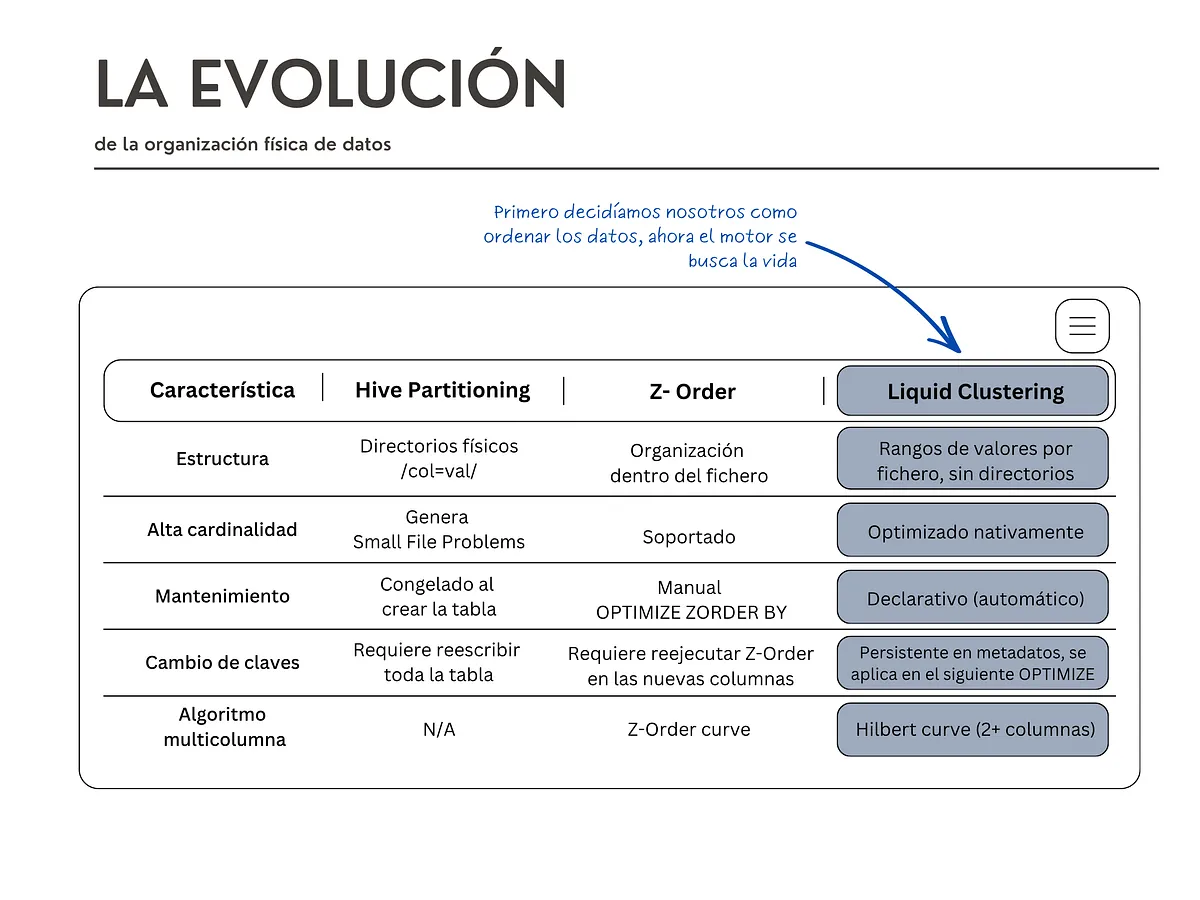 Taula de característiques segons l’organització física de les dades
Una cosa important: no ho pots barrejar tot
Liquid Clustering i Hive Partitioning no són dues capes que puguis posar l’una sobre l’altra. A Fabric, has de triar una estratègia per a la taula. La diferència senzilla seria:
- Partitioning: divideix físicament les dades i et pot anar bé quan necessites aïllar escriptures concurrents.
- Liquid Clustering: organitza les dades pensant sobretot a millorar les lectures i el file skipping.
Així que abans de pensar «com combino totes dues?», la pregunta és més aviat: quin problema intento resoldre?
Abans de començar: quin Runtime tens?
Aquí hi ha un petit parany: Liquid Clustering no es comporta exactament igual a tots els Runtimes.
A Fabric:
- Runtime 1.3 → Delta Lake 3.2
- Runtime 2.0 → Delta Lake 4.2
Al Runtime 2.0, el clustering incremental fa que OPTIMIZE pugui anar reorganitzant les dades sense haver de refer-ho tot cada vegada.
Al Runtime 1.3 també pots treballar amb Liquid Clustering, però té més limitacions i el comportament de l’optimització és diferent.
Així que, abans de copiar un exemple d’Internet i pensar que Fabric s’ha trencat, mira primer quin Runtime fas servir.
Ara sí, declarem el clustering
En una taula nova:
CREATE TABLE dbo.ventas (
    order_id BIGINT,
    order_date DATE,
    region STRING,
    amount DECIMAL(10,2)
) CLUSTER BY (order_date, region);
Des d’una query:
CREATE TABLE dbo.ventas_clustered
CLUSTER BY (order_date, region)
AS SELECT * FROM raw_ventas;
O activar-lo sobre una taula que ja existeix, sense reescriure res:
ALTER TABLE dbo.ventas_txn CLUSTER BY (order_date, region);Per triar les columnes:
- Entre 1 i 4, i les que surtin de debò als teus
WHERE. No triïs les columnes que «semblen importants» al model. Tria les que realment apareixen als filtres de les teves consultes. Més columnes no vol dir més optimització. Al contrari: com més intentes optimitzar alhora, més difícil és aconseguir que cadascuna quedi ben organitzada. - L’ordre és igual. L’ordre després de
CLUSTER BYno afecta el resultat. - Compte en barrejar cardinalitats. Ajuntar una columna amb tres valors diferents i una altra amb un milió aprofita malament la de baixa cardinalitat.
- Tipus NO vàlids:
BooleanType,BinaryTypeiNullTypeno serveixen com a clau (un booleà només té dos valors: no hi ha res a ordenar). Numèrics, dates, timestamps i strings sí. Els tipus complexos (Struct,Array,Map) només des del Runtime 2.0 i activantspark.microsoft.delta.clusteredTable.complexTypes.enabled.
D’acord, i ara qui mou els fitxers?
Declarar les columnes no mou ni un byte. Només n’apunta la intenció. Qui col·loca les dades és OPTIMIZE:
OPTIMIZE ventas;Ja està. Sense ZORDER BY, sense recordar quines columnes vas posar l’última vegada, perquè són a les metadades.
Al Runtime 2.0, a més, el Native Execution Engine admet OPTIMIZE sobre taules clusteritzades i dona entre un 30% i un 50% més de velocitat.
I si demà canvio d’idea?
Que és tota la gràcia d’això:
-- Canviar columnes
ALTER TABLE ventas CLUSTER BY (region, product_category);

-- Treure’l
ALTER TABLE ventas CLUSTER BY NONE;
El layout nou s’aplica al següent OPTIMIZE. Els fitxers antics conserven la distribució prèvia fins que els toca reorganitzar-se.
Quan canviïs de claus, llança un cop:
OPTIMIZE ventas FULL;OPTIMIZE FULL força la reorganització dels grups que encara segueixen el criteri antic. És més car, així que reserva’l per quan canviïs columnes o vulguis un reset de qualitat. No el posis a la pipeline diària.
Com sé si realment ha millorat?
No em refiaria només que OPTIMIZE hagi acabat correctament. L’interessant és saber si realment ha deixat el layout millor. Des del Runtime 2.0 tens un mètode per no anar a cegues (només Scala, de moment):
import io.delta.tables.DeltaTable

deltaTable = DeltaTable.forName(spark, "dbo.ventas")
display(deltaTable.clusteringQuality())
Retorna una fila per columna de clustering. Les tres mètriques que jo miraria:
avg_depth: et dona una idea de quants fitxers hauria de tocar una consulta per trobar un valor. Com més a prop d’1, millor.overlap_ratio: mesura quant es trepitgen els rangs entre fitxers. Com més baix, millor.skipping_effectiveness: indica quant pot descartar el motor gràcies a les estadístiques dels fitxers. Com més alt, millor.
Llança-ho abans i després de l’OPTIMIZE i compara. I tingues present que això estima el potencial de file skipping a partir de les estadístiques dels fitxers: no mesura el temps real d’una query concreta.
El que convé saber abans de posar-lo a la pipeline
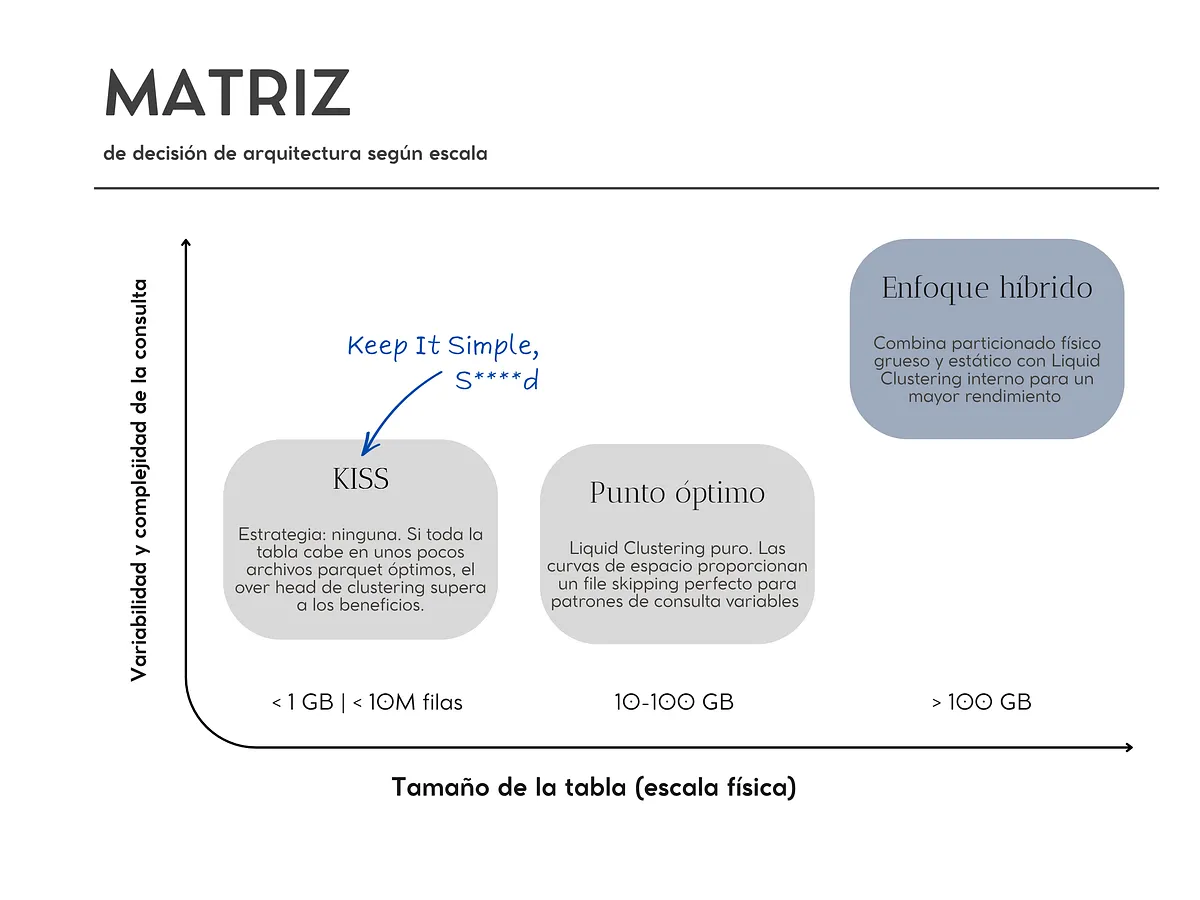 Matriu de decisió segons la mida de la taula
- Auto compaction: es pot fer servir per ajudar a mantenir a ratlla el problema dels fitxers petits.
- V-Order: compatible. Treballen en eixos diferents. V-Order optimitza com està ordenat el contingut dins de cada fitxer; el clustering decideix quines files van a quin fitxer.
- Optimize write: compatible, i recomanable en streaming perquè cada tanda de dades no generi un eixam de fitxers minúsculs.
- Notebooks Python: aquí ve un d’aquells paranys que descobreixes quan ja tens mitja pipeline muntada. No tots els motors que treballen amb Delta poden escriure Liquid Clustering. A Fabric, l’escriptura de Liquid Clustering està suportada per Fabric Spark. Els notebooks Python no tenen aquest suport per escriure Liquid Clustering. No és que Python i Delta no s’entenguin. És simplement que aquesta funcionalitat necessita Fabric Spark. D’aquelles coses que està bé saber abans i no quan la pipeline ja està muntada.
- Auto reclustering: a la 2.0 va sol. A mesura que arriben dades noves, els rangs dels fitxers es tornen a trepitjar i el file skipping empitjora. El motor ho detecta i reorganitza només els fitxers afectats, dins de l’
OPTIMIZEnormal. No cal programar res. - Deletion vectors: quan esborres files, Delta no reescriu el fitxer: apunta a part quines files cal ignorar en llegir. Els fitxers que acumulen massa esborrats se seleccionen per reorganitzar-se encara que ja estiguessin ben clusteritzats.
Si ets al Runtime 2.0, per a mi Liquid Clustering hauria d’estar força amunt a la llista de coses a provar quan una taula comença a tenir problemes de layout. Et treus de sobre part del manteniment manual de Z-Order i pots canviar les columnes de clustering sense refer la taula.
Abans de llançar-te a canviar el layout d’una taula, jo em faria quatre preguntes:
- Com es consulta aquesta taula?
- Tinc un problema de lectura o d’escriptures concurrents?
- Quin Runtime i quin motor fa servir la meva pipeline?
- Realment necessito canviar com estan organitzades les dades?
Perquè Liquid Clustering no és «la manera nova de particionar».
És una altra manera de dir-li a Fabric com vols que organitzi les teves dades perquè sigui més fàcil trobar-les.
I ara ve la part que m’interessa: ja l’heu provat? Sobretot en taules grans, amb molts MERGE. Vull saber quin avg_depth esteu veient per aquí.
T’ha servit? Aplaudeix, sense compte. Pots fer-ho diverses vegades.
Comentaris